首页
语音助手回话时,声音是跟着它”边想边说”一起出来的,不是等它把整段话想完才开口,这就是流式语音合成(Streaming TTS)在干活。它跟”先生成一整段完整音频、再一次性播放”的离线合成是两回事:流式合成是文字来一点,声音就跟着出一点。语音助手、实时配音、直播AI主播这些”说话不带停顿感”的产品,背后基本都靠它。
一. 先把几个容易混的概念分清楚
| 概念 | 解决什么问题 | 和流式合成的关系 |
|---|---|---|
| 离线语音合成 | 拿到完整文本,一次性合成整段音频,追求音质和韵律最优 | 流式合成的对照面,有声书、配音这类不追求即时响应的场景通常用离线合成,音质上限更高 |
| “实时语音合成”(口语说法) | 强调合成速度跟得上播放速度,音频不会边播边卡 | 和”流式”经常混用,但严格说”实时”讲的是速度够不够快,”流式”讲的是文字进多少、声音出多少这种工作方式——一套系统可以是流式的但合成得不够快,也可能是非流式但因为文本短、算得快而看起来”很实时” |
| 语音克隆 / 声音复刻 | 用某个人的少量录音,训练出能模仿这个音色的合成能力 | 是”用谁的声音说”的问题,流式是”多快开始说”的问题,两个维度可以叠加——难点在于实时场景下留给克隆模型的计算时间很有限 |
| SSML(语音合成标记语言) | 用标签控制停顿、重音、数字读法等细节 | 流式场景下 SSML 标签必须在文本片段到达时就能被识别和处理,不能等全文都到齐才生效 |
二. 模型怎么做到边收文字边出声音
离线合成可以等——拿到一整段文本,通盘规划好每个字该用什么音高、什么节奏,再一次性生成音频,怎么好听怎么来。流式合成没这个条件,文本可能是从大模型那边一个词一个词蹦出来的,合成引擎得在只看到”半句话”的时候就开始出声。
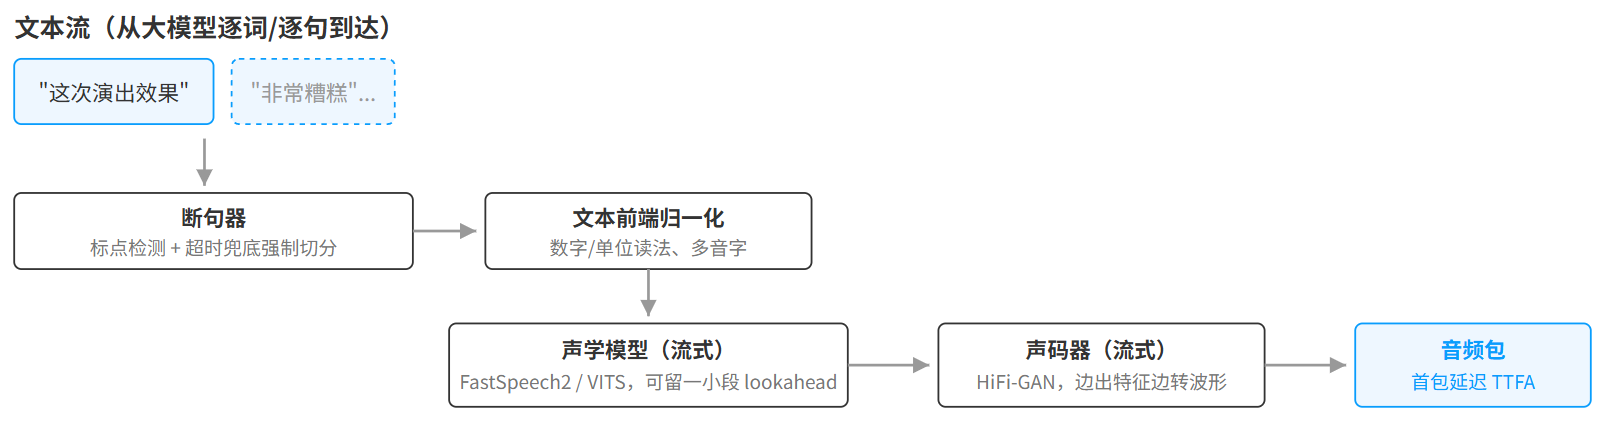
拆开看,一套合成系统大致要经过这几步:文本前端先做归一化(把”3.14″读成”三点一四”还是”圆周率”,把日期、单位读对),再交给声学模型预测每一帧的声学特征(常见的有 FastSpeech2、VITS 这类结构),最后由声码器(Vocoder,比如 HiFi-GAN)把这些特征转成真正能播放的波形。流式版本的关键是把这几步都改成能”边收边处理”的模式,声学模型和声码器都不能等全部文本到齐才开始工作:
三. 断句断早了会”变调”,断晚了会卡顿
流式合成有个和流式识别很像、但方向相反的跷跷板。流式识别是”看得越少,文字越容易猜错”;流式合成是”看得越少,语气越容易配错”。
拿一句常见的话举例:”他这次考试成绩……只有 58 分。”如果合成引擎在听到”他这次考试成绩”的时候就得马上开始发声,它其实并不知道后面接的是好消息还是坏消息——这几个字用上扬的语气还是低沉惋惜的语气,全凭后半句才能定。等”只有 58 分”这几个字到了才发现猜错了调,声音已经播出去了,改不回来。这种”一句话被切成好几段分别合成,段与段之间语气接不上”的问题,是流式合成里公认还没被彻底解决的难题,现在比较常见的缓解办法,是让声学模型多留一小段”lookahead”——先偷看下一段文本再决定当前这段怎么发音,用少量延迟换语气连贯性。
断句策略本身也是一门学问:切得太碎(比如按词切),合成引擎没有足够上下文判断该用什么语调,容易读得一字一顿;切得太整(等一整句甚至一整段到齐),首包延迟又上去了。比较实用的做法是”标点优先,超时兜底”——正常情况下按逗号、句号这些标点切,如果大模型迟迟不给标点(比如在输出一长串没有标点的列表),就设一个字数或时间上限强制切一刀。另外,首包延迟(TTFA,Time To First Audio,从决定要说话到用户听到第一个声音之间的时间)是流式合成最关键的体验指标,实践中通常会让第一段刻意切得比后面短一些,优先让用户尽快听到声音,后面的分段可以适当放宽。看这项指标也不能只看平均值,更要看 95、99 分位——用户记住的是等得最久的那一次,不是平均体验。
四. 接进真实产品,还有这几个注意事项
大模型吐出来的文本,不是干干净净的句子
大模型输出是一个词一个词往外蹦的 token 流,不会贴心地在每句话结尾给你一个句号,遇到数字、网址、代码片段、表情符号,断句和归一化都得实时处理,不能像离线场景那样等全文到齐再统一清洗。
被打断的时候,声音得停得干脆
用户说话打断 AI 的时候,播放要立刻停,但合成引擎往往已经提前生成了一小段还没播放的音频缓冲——这部分算力等于白费,而且如果直接硬切,容易出现”咔”的一声突兀截断,需要做淡出处理才自然。这块涉及的打断检测、全双工对话机制,声网博客里专门写过,这里就不重复展开了。
音频要实时编码打包送出去,网络还得接得住
合成出来的音频不是一整个文件,而是一帧一帧生成、一帧一帧编码(比如编成 Opus)发送出去的,接收端要有播放缓冲区来抹平网络抖动。缓冲区留短了容易卡顿,留长了整体延迟又上去了,这个取舍和流式识别里的抗弱网问题是同一类工程权衡,只是发生在音频输出这一端。
实时声音克隆,算力和效果得二选一让一步
离线声音克隆可以用更大的模型、更长的参考音频反复打磨音色相似度;流式场景下留给克隆模型的计算时间很紧张,通常得在”像不像”和”快不快”之间让音色效果做一点让步。
五. 应用场景
- 语音助手 / 对话式 AI Agent:大模型一边生成回复文字,语音一边跟着播出来,是”像在聊天”还是”像在等广播”的关键。
- 实时配音 / AI 主播:直播或短视频场景下,文案边生成边配音,不用等整段文案写完才开始出声。
- 无障碍朗读:为视障用户实时朗读界面内容或消息,对首包延迟比较敏感。
- 客服机器人:结合流式识别和大模型,构成”听清-想清-说出”的完整实时对话链路。
六. 几个经常被问到的问题
流式合成的音质是不是一定比离线合成差?
整体上限确实会受限,离线合成能通盘规划整句话的语气,流式合成受限于”边收边出”,尤其在句子中间切分的地方,语气衔接会打点折扣。不过差距在缩小,配合 lookahead 缓冲和更好的断句策略,多数场景下听感已经足够自然。
为什么有的语音助手说话时语气会突然”变调”?
第三节讲过的问题,句子被切成几段分别合成,前一段生成时还不知道后面内容的感情色彩,等后面内容揭晓才发现语气没配对,但声音已经播出去了。这是流式合成目前还没被彻底解决的技术难点。
流式合成和流式识别,工程上的坑是一回事吗?
不是一回事,但形状很像。流式识别的核心矛盾是”看得越少,文字越容易错”,流式合成的核心矛盾是”看得越少,语气越容易配错”,两者都要在”多等一点更准/更自然”和”少等一点更快”之间找平衡点。