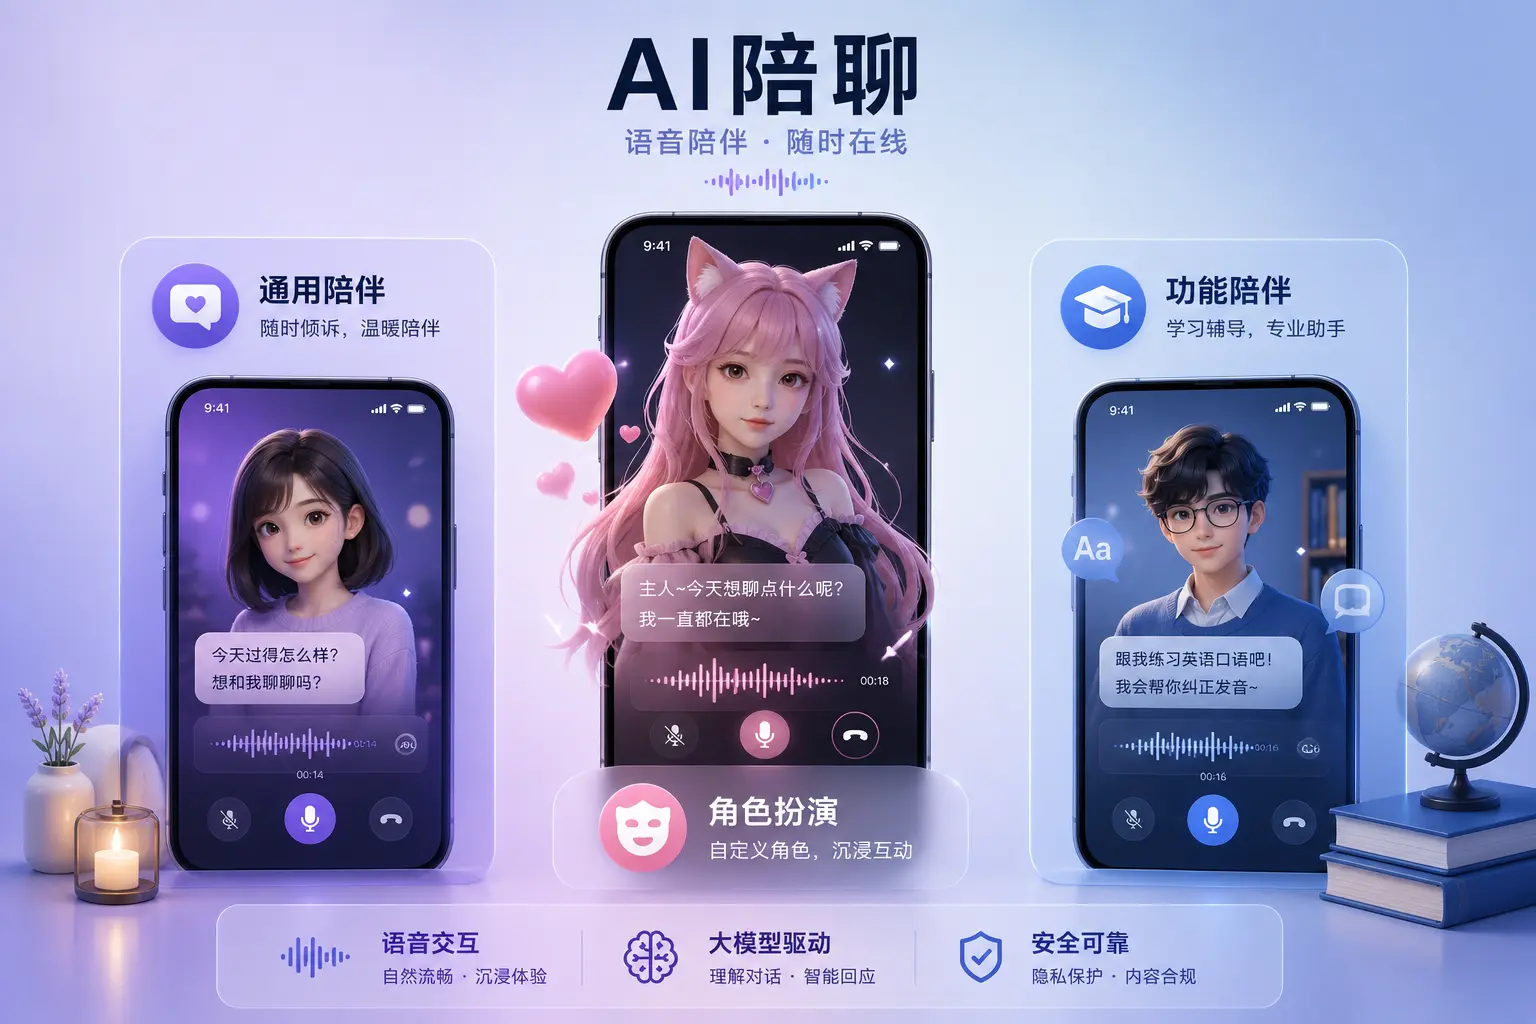
在应用商店搜“AI陪聊”,能跳出几十款产品:星野、猫箱、Talkie,还有一些头部社交产品内置的“AI搭子”功能。它们定位各异,但底层做法大体一致:把语音转成文字、交给大模型生成回复、再合成语音传回用户。也正因如此,AI陪聊开发的难点不在选哪家模型,而在支撑整段对话流畅进行的语音链路。
一条链路,四段都不能掉链子
用户说一句话,背后要经过四个环节:
– 采集与传输(RTC):把声音从设备传出,再把回复送回来;
– ASR:把语音转成文字;
– LLM:生成回复内容;
– TTS:把文字合成语音。
四段里任何一段出现短板,用户感知到的都是同一句话——“这 AI 反应有点慢”。
延迟与打断:语音陪伴的硬指标
行业通常以端到端延迟 1 秒以内作为参考线。声网 2025 年 3 月发布的对话式 AI 引擎将这一数字做到 650 毫秒;用户中途插话打断 AI 时,响应约 340 毫秒,已接近人与人对话 200 毫秒左右的自然轮转间隔。
几百毫秒的差距,落到体验上就是“慢半拍”与“像在跟真人聊天”的区别。这也是 AI 陪聊和普通聊天机器人的分水岭:后者可以接受数秒等待,语音陪伴一旦停顿超过一两秒,对话感就断了。
看不见的前处理模块,同样决定体验
– VAD:判断何时是人在说话、何时是环境噪音,判断失准会让 AI 抢话,或者该接话时保持沉默;
– AGC 与 AEC:处理设备侧问题,例如外放时 AI 把自己刚说的话识别成用户在说话。
这些模块加上后续的语义处理,共同决定了同一句话在不同产品里听起来是流畅还是卡顿。把 AI 陪聊简单理解成“调用一个大模型”并不准确——模型只是链路中的一环。
选型:模型与语音能力可以灵活组合
声网对话式 AI 引擎支持接入 OpenAI、DeepSeek 等主流大模型,以及国内外主流语音合成供应商,开发者可以按成本、语言和合规要求调整,不必绑定单一供应商。
由此,“AI 陪聊怎么开发”拆到最后,往往落在两个具体问题上:选哪条语音链路,以及能不能自由更换大模型。
整体来看,AI陪聊开发要解决的问题相对集中:链路是否稳定、延迟能否压进自然对话的区间、打断与降噪是否可靠。声网将持续提供实时互动与对话式 AI 能力,支持开发者与硬件厂商把精力放在产品与内容创新上。