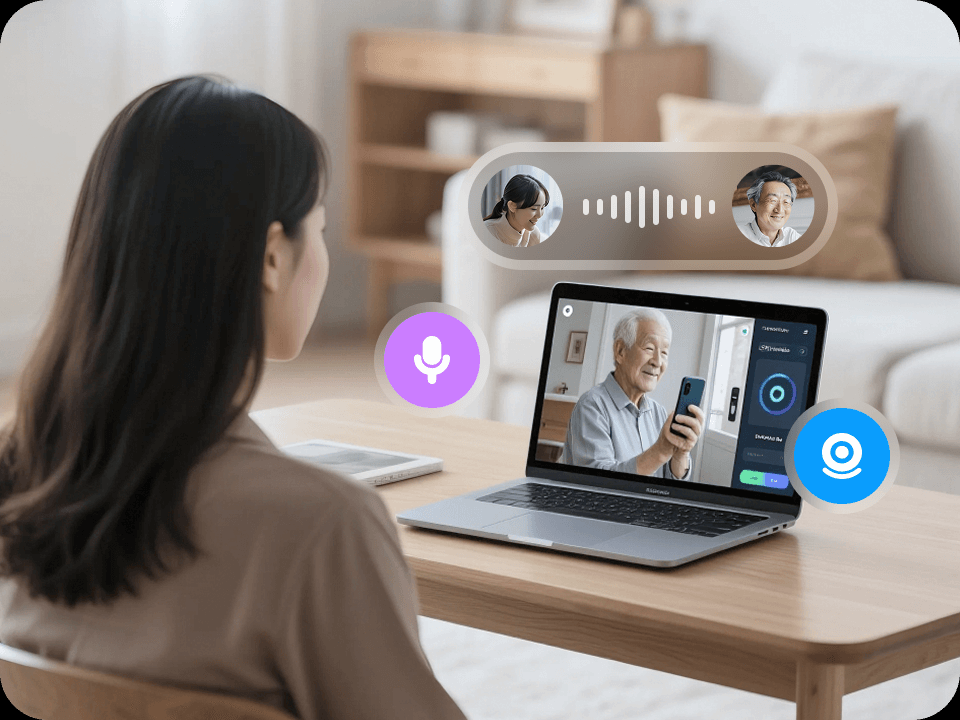
在安静环境下演示一段语音对话,大多数方案都能表现得不错。但用户真正使用AI语音助手的场景,往往是嘈杂的客厅、信号不稳的卧室,或是一家人同时说话的餐桌。实验室与真实环境之间的落差,正是AI语音助手落地时最容易被低估的部分。市面上常见的做法是在大模型前后分别接入ASR和TTS,快速拼出一套对话能力,但环境噪声、多人并行发言、用户随时插话等状况,会让这套拼接方案的短板集中暴露。
第一道门槛:延时
当大量用户同时调用模型时,Token生成速度会下降,响应延迟随之上升。对于文字对话,多等一两秒或许可以接受;但对于AI语音助手,超过一定阈值的延迟会直接打断对话节奏,用户感受到的是“它反应慢”甚至“它没听懂”。声网对话式AI引擎将语音对话延迟中位数控制在650ms,打断响应低至340ms,让对话节奏更接近人与人之间的自然交流。
第二道门槛:AI“不会听”
在多人交谈的环境中,AI难以判断当前应该响应谁;环境噪声和旁人说话会干扰识别;人可以随时打断对方,但AI往往不知道该在什么时候停下。声网对话式AI引擎通过选择性注意力锁定与声纹识别,屏蔽约95%的环境人声和噪声,帮助设备锁定当前对话人声。声纹识别还让设备能够区分不同说话者。
第三道门槛:网络稳定性
家庭Wi-Fi质量参差不齐,设备又常被放在信号较弱的角落。声网对话式AI引擎支持80%以上的抗丢包,断网3到5秒仍能保持对话连贯。
从“能对话”到“可陪伴”,还需要身份与记忆
除了上述工程门槛,AI语音助手在家庭场景中还面临一个更深层的问题:它到底是玩具,还是伙伴?不少AI硬件开箱体验尚可,但留存率很低,用户玩两天便放在角落。核心原因在于,设备没有解决身份识别与长期记忆两个问题。声网通过声纹识别技术,让实体AI硬件可以通过声音识别出对话对象是谁。当AI知道自己正在和谁对话,才有可能建立专属记忆,沉淀人与AI之间的对话经历,把碎片化聊天变成有温度的长期陪伴。
目前,声网对话式AI引擎已覆盖AI陪伴玩具、AI语音助手、机器人等多种应用场景,并在情感陪伴、教育、智能家居、智能车载等领域实现落地。对于正在开发AI语音助手的团队而言,模块拼接可以快速验证概念,但要在真实场景中达到可用标准,延时控制、打断处理、噪声过滤、弱网稳定性和身份识别这些工程环节的完成度,共同决定了产品能否被用户长期使用。