首页
打电话的时候对方一边说话,字幕一边往外蹦,这就是流式语音识别(Streaming ASR)在干活。它跟”录完一段音再整体转文字”的离线识别是两码事,流式识别不等你说完,音频进来多少就处理多少,边听边吐结果。直播字幕、会议实时转写、语音输入法、智能客服里那种”你一说话它就有反应”的体验,背后基本都是它。
一. 先把几个容易混的概念分清楚
“流式识别””实时识别””离线识别”这几个词经常被当成一回事说,其实各管各的维度:
| 概念 | 解决什么问题 | 和流式识别的关系 |
|---|---|---|
| 离线语音识别 | 拿到完整音频文件,一次性转写,追求准确率最大化 | 流式识别的对照面,很多系统会在流式出结果之后,用离线级别的模型再校准一遍 |
| “实时语音识别”(口语说法) | 强调识别速度跟得上说话速度(实时率 RTF < 1) | 日常口语里经常和”流式”混着用,但严格说”实时”讲的是速度,”流式”讲的是边输入边输出这种工作方式,两者常常同时具备,但不是同一件事——一个离线模型如果跑得够快,也能满足”实时率”,但它依然不是流式识别 |
| 语音唤醒 / 关键词检测(KWS) | 只判断”有没有说到某个特定词”(比如”你好,小X”),不做完整转写 | 常年低功耗常驻监听,命中关键词之后才唤起完整的流式识别,两者是前后接力的关系 |
| 说话人分离(Speaker Diarization) | 判断”这段话是谁说的”,不管说了什么内容 | 和流式识别是两个独立任务,会议转写场景通常两个一起跑,一个管”是谁”,一个管”说了啥” |
二. 模型怎么做到边听边出字
离线识别可以等——拿到一整段完整音频,从头到尾扫一遍,怎么准怎么来。流式识别没这个待遇,音频一小段一小段进来,模型得在只听到”半句话”的情况下先吐一个结果,不能干等着。
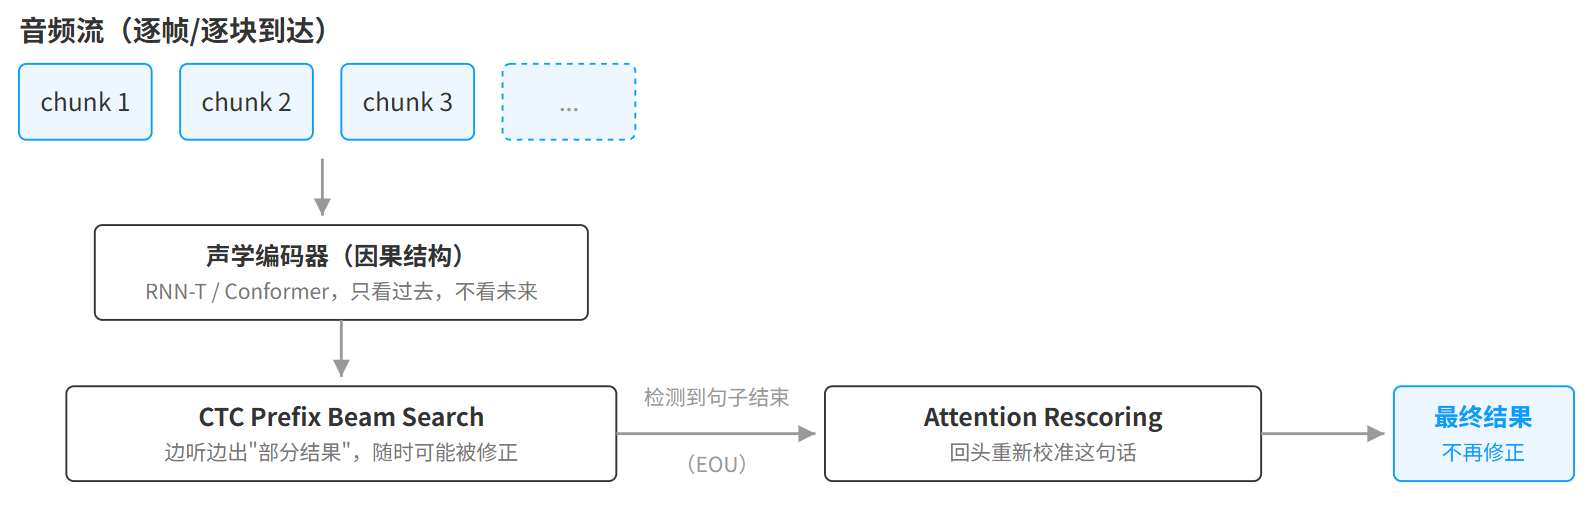
常规做法是把模型改成”因果”结构:把音频切成一个个小片段(chunk),每一步的输出只依赖当前片段和过去听到的音频,不能偷看后面还没来的部分。现在主流的流式架构大多是 RNN-T(RNN Transducer)或者 Conformer 这类结构,配合 CTC Prefix Beam Search 之类的解码算法,边听边搜出一个大概靠谱的文本序列,先吐出来;等一段话说完,再用 Attention Rescoring 之类的方法回头把这段话重新捋一遍,把最终结果校准得更准——这个”先出一版、再校准一版”的流程,业内通常叫两遍解码(2-pass)。整个链路画出来大致是这样:
三. 字幕为什么会自己”改口”
用过直播字幕或者语音输入法的人大概都见过这个场景:屏幕上先冒出来一个词,隔半秒它自己变成了另一个词。很多人以为是识别错了在纠错,其实这是流式识别的工作方式决定的——模型只听到部分音频时先给一个当下最像的猜测,等后面的音频到了、上下文更全了,发现猜错就把已经吐出去的字撤回来改一版。上面那张图里”CTC Prefix Beam Search”吐出来的部分结果,就是随时可能被后面的 Attention Rescoring 推翻的。业内把这个叫”结果回退”。改得越频繁,字幕看着就越闪,用户体感就越差。
这背后是一个绕不开的跷跷板:出字越快,能看到的上下文越少,准确率天然打折扣;想等更多上下文再出字,用户就得多等。怎么权衡,直接决定产品好不好用。所以光看词错率(WER)判断一套流式识别服务的好坏是不够的,首字延迟(第一个字多快出来)、尾字延迟(说完话多久拿到确定结果)、回退率(吐出去的字后来又被改的比例)——这三项加起来才是实际体感。同样 WER 的两套系统,回退率差一倍,用起来完全是两种东西。
四. 网络传输里的几个坑
大部分讲流式语音识别原理的内容,讲到模型架构基本就收尾了。但音频如果是经过一段真实网络传过来的(比如打电话、开会、连麦),还有几个问题跟模型准不准没关系,纯粹是网络传输带来的:
丢包补出来的声音,模型听着是”假”的
网络抖动丢包是常态,接收端为了让声音不那么卡,会用丢包补偿(PLC)技术,用算法”编”一段声音填上去。人耳未必察觉,但对识别模型来说,这段编出来的音频跟真实语音在频谱细节上有差异,准确率会悄悄往下掉。离线识别基本不会遇到这个问题,因为它用的通常是完整无损的录音文件。
网络一抖,端点检测就容易掐错时机
流式识别靠 VAD/EOU(语音活动检测/说话结束判断)判断”这句话说完了没”,音频到达的节奏一乱,端点检测很容易把说话中间的停顿当成说完了,提前掐断;或者反过来,真说完了还在傻等,白白多花几百毫秒。
会议里好几个人一起说话,识别该怎么分账
多人连麦场景,每路音频单独送去识别,还是混音后统一识别?分开识别准确率有保障,但每路都占一份算力,成本上去了;混音识别成本低,两人抢话的时候准确率会明显往下掉。做多人实时产品的团队迟早会撞上这个选择题。
产品名、人名这类词,实时场景没工夫”回头想”
这类长尾词离线识别可以靠更大的语言模型、更多轮候选重排来纠正,流式场景留给模型反悔的空间很小,通常得靠热词词典之类的定向增强,提前把这些词塞进识别器的优先候选里。
五. 用在哪些地方
流式语音识别目前用得最多的几类场景:
- 直播和短视频字幕:主播说话同步出字幕,方便听障用户或者静音场景下的观众跟上内容。
- 会议实时转写:多人会议边开边生成文字记录,通常还要配合说话人分离,标注”谁说了什么”。
- 语音输入法:对首字延迟和回退率最敏感的场景之一,打字体验的流畅度基本就看这两项指标。
- 智能客服 / 语音助手:靠流式识别配合端点检测,判断用户什么时候说完了、能不能被用户打断,是语音交互”像人聊天”还是”像对讲机”的关键。
- 无障碍字幕:为听障用户提供实时字幕辅助,对准确率和延迟都有较高要求。
这些场景有个共同点:用户对”等待感”很敏感,慢一点就会觉得不好用。
六. 几个经常被问到的问题
流式识别牺牲准确率换速度,划算吗?
很多系统的做法是分两步走:先用流式识别快速吐一版”大概能看”的结果,等这句话说完,再用一轮更完整的解码把结果重新校准,也就是前面提到的两遍解码(2-pass)。这样实时性和准确率都能要。
字幕”蹦出来又改字”是识别错了吗?
第三节讲过,这是流式识别边听边猜的正常副作用,不是错误。改得多不多、看着闪不闪,本身就是衡量一套流式识别服务好不好的关键指标。
流式识别和语音唤醒(KWS)是一回事吗?
不是。语音唤醒只负责判断有没有说到某个特定词,做完整句子转写的是流式识别,两者常常接力工作,先用语音唤醒低功耗监听,命中后再启动流式识别。
弱网环境下,怎么保证识别准确率不崩?
光靠网络层面的抗弱网优化还不够,识别引擎能不能扛住丢包补偿之后失真的音频、端点检测能不能扛住抖动误判,这两项在只测干净录音的评测数字里根本看不出来。