首页
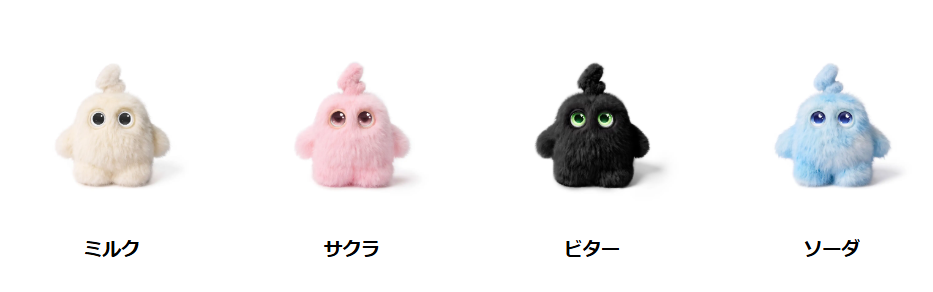
2026 年 11 月 17 日,智能家居品牌 SwitchBot 在日本举行品牌十周年新品发布会,正式发布掌心大小的 AI 宠物 KATA Friends mini。这款产品可以挂在背包上随身携带,支持自然语言聊天、触摸反馈、个性化性格养成,还可以通过语音操作兼容的 SwitchBot 智能家居设备。用户可以通过日常聊天和互动,让宠物逐渐形成个性化的回应方式。抚摸设备时,它还会通过眼部表情、声音和灯光作出反馈。
这款新品延续了 AI 陪伴硬件近年来的一种产品方向:用户可以随时与设备说话,也希望它记住之前交流过的内容,并通过声音、表情甚至其他设备动作作出回应。
对于 AI 智能玩具开发者而言,自然语音交互涉及的不只是接入一个大语言模型。从麦克风采集、实时音频传输,到语音识别、对话管理、语音合成和设备反馈,每个环节都会影响最终体验。
一. SwitchBot KATA Friends mini,带来了哪些交互功能?
KATA Friends mini 是 SwitchBot 旗下 KATA Friends 产品系列的小型化新品。此前的 KATA Friends 已经支持语音指令、面部及手势识别、身体动作反馈等功能。mini 则更侧重随身携带、语音聊天和日常陪伴。
从此次发布的信息来看,有三项能力比较值得关注。
1. 自然语音聊天与个性化性格
用户可以向 KATA Friends mini 讲述日常生活,或进行普通聊天。产品提供四种初始性格,并通过持续互动形成不同的个性化表现。
AI 陪伴玩具与普通语音助手的使用方式有所不同。
用户询问天气、设定闹钟时,通常期待设备快速返回明确结果。但在陪伴场景中,用户可能只是想聊一聊今天发生的事情,并没有具体的任务目标。
因此,设备不仅需要理解用户说了什么,还要结合当前话题、历史交流和角色设定组织回答。
对于这类应用,长期记忆可以保存经过筛选的用户偏好、互动经历及角色状态。但如何提取、更新和使用这些信息,仍取决于产品自己的记忆系统设计。
2. 触摸、声音和表情共同参与交互
KATA Friends mini 不只通过语音回应。用户抚摸设备时,它也可以通过眼部表情、声音和灯光反馈。
这类设计涉及两套不同的交互机制。
一套是语音对话:用户说话,系统理解内容,然后生成语音回复。
另一套是设备本地交互:触摸传感器检测操作后,控制表情、灯光或其他反馈部件。
两者可以独立运行,也可以通过设备状态管理相互配合。例如,用户一边抚摸玩具一边说话时,产品可以根据当前状态选择合适的表情和回复。
不过,SwitchBot 尚未公开 KATA Friends mini 完整的音频处理、模型部署和设备控制架构,因此不能直接推断它采用了哪一种实时通信协议。
3. 从语音聊天延伸到智能家居控制
根据官方发布的信息,KATA Friends mini 还支持通过语音操作兼容的 SwitchBot 产品。
例如,用户可以通过对话提出家电控制需求,由系统将意图转换为相应的设备操作。
这类功能通常涉及语音识别、意图理解、设备查询、控制接口调用和执行结果反馈。
以“帮我把灯关掉”为例,设备需要确定用户希望控制哪一盏灯、目标设备是否在线,以及控制命令有没有执行成功。
对 AI 智能玩具而言,聊天和设备控制可以共用语音入口,但业务处理方式应当区分。特别是门锁、家电等实体设备的控制,需要权限验证、状态检查和必要的操作确认。
二. AI 智能玩具的自然语音交互,技术难点在哪里?
现在,开发者已经可以通过模型 API 实现语音识别、文本生成和语音合成。但将这些能力装进一款能够日常使用的 AI 玩具,还需要考虑硬件条件、网络环境和用户的实际说话方式。
1. 麦克风藏在玩具内部,怎样保证语音识别质量?
毛绒玩具通常需要将麦克风隐藏在外壳或布料内部。麦克风的位置、外壳结构、布料厚度都会影响声音采集。
此外,用户不一定会正对玩具说话。设备可能放在桌面、床头,也可能挂在背包上,周围存在电视声、空调噪声、其他人说话以及设备扬声器自身播放的声音。
因此,音频采集通常需要结合自动增益控制(AGC)、噪声抑制(ANS)、回声消除(AEC)和语音活动检测(VAD)。
这些技术分别处理不同问题:
- AGC:在一定范围内调整语音音量,减少输入音量变化的影响。
- ANS:降低背景噪声对语音采集和识别的干扰。
- AEC:减少设备扬声器播放的声音重新进入麦克风,造成回声或自我触发。
- VAD:检测音频中的语音活动,辅助确定何时开始处理用户输入。
需要注意,VAD 主要识别语音活动,不等同于语义理解。即使系统检测到一段静音,也不能立即确定用户已经把话说完。
2. 用户说话中途停顿,玩具会不会抢话?
在 AI 陪伴场景中,用户经常会停下来思考。
例如:“我今天在学校……有一件不太开心的事情。”
如果系统在用户第一次停顿时就结束当前轮次,AI 可能提前开始回答,打断用户后面想说的话。
另一方面,如果系统设置了过长的静音等待时间,即使用户已经说完,玩具也可能迟迟没有回应。
实际开发中,可以结合 VAD、ASR 中间结果和语义轮次检测(Semantic Turn Detection),判断用户是否已经完成表达。
对于不同的产品角色,判停策略也可以有所区别。例如,面向儿童的故事陪伴玩具,可以适当照顾儿童表达不连续的特点;偏向快捷指令的语音设备,则通常更重视响应速度。
3. 玩具正在说话时,用户能不能随时打断?
AI 玩具可能正在讲故事,用户突然说:“不要讲这个了,我想听恐龙的故事。”
如果产品必须等到上一段语音全部播放完才能识别新指令,用户就很难按照自然交流的习惯使用。
智能打断(Barge-in)需要让设备在播放语音时仍能检测新的用户输入,并在确认打断意图后,停止当前播放、处理新请求。
这里还有一个上下文问题。
模型生成的内容不一定已经全部播放。例如,AI 已经生成了一分钟的故事,但用户在第十秒打断,那么后续对话不能简单假设用户已经听过完整故事。
系统应根据播放器状态、打断事件和可获得的语音对齐信息,管理已播报内容与尚未播放的内容。
这样,下一轮回复才能正确接续用户实际参与的对话。
4. 对话响应时间如何控制?
采用云端大模型的 AI 玩具,通常需要经历音频采集、传输、语音识别、模型处理、语音合成和音频返回等步骤。
对于需要访问长期记忆或执行设备操作的请求,还可能增加数据库检索和工具调用。
开发者可以通过流式 ASR、流式 LLM、流式 TTS 和实时音频传输减少等待,并尽可能让部分处理过程并行执行。
例如,TTS 不一定需要等模型生成完整段落后才开始工作,可以在获得适合合成的文本片段后逐步生成音频。
但评估语音响应速度时,需要区分模型首 Token 时间、TTS 首包时间,以及用户说完话到真正听见回复的端到端等待时间。
前两项是局部指标,不能直接代表最终语音体验。
三. AI 玩具如何记住用户,并形成持续的陪伴体验?
KATA Friends mini 公布的个性化性格养成,也对应着 AI 陪伴产品的一项重要能力:跨会话记忆。
用户第一次与设备聊天时,可能会介绍自己的名字、喜欢的动物或平时的兴趣。过几天再次打开设备,如果还要重新介绍相同的信息,个性化体验就很难持续。
Agent Memory 可以用于保存这些经过筛选的信息,并在后续对话中按需检索。
1. 当前会话和长期记忆需要分开管理
当前会话上下文负责保存最近几轮交流,例如用户正在讲的故事、刚提到的人物或当前的话题。
长期记忆则可以保存适合跨会话使用的信息,例如用户允许保留的称呼、喜欢的故事类型、此前约定的互动内容,以及设备角色的长期设定。
对于一款长期使用的 AI 玩具,没有必要每次都把全部历史聊天发送给模型。
应用可以根据当前话题检索相关记忆,再将必要内容加入模型上下文。这种做法既可以减少 Token 消耗,也有助于控制无关历史信息对回答的干扰。
关于具体技术原理,可以参考《AI Agent Memory 是什么?为什么 Agent 需要长期记忆?》。
2. 记忆系统不能把所有聊天都保存下来
AI 玩具可能在家庭环境中使用,甚至面向儿童,因此需要更加谨慎地处理语音和个人信息。
例如,普通聊天中的临时信息未必有长期保存的必要;用户明确要求删除的个人化记录,应有对应的数据处理机制。
如果设备支持多名家庭成员使用,还需要避免将不同人的偏好混在一起。
对于儿童产品,开发者应结合目标市场的适用法规设计监护人授权、数据收集范围、保存期限和删除机制。
长期记忆可以改善个性化体验,但它本身不能保证用户一定会产生情感连接,更不能替代对数据安全和隐私保护的要求。
四. Fuzozo 芙崽:声网对话式 AI 在毛绒玩具中的实际应用
在 AI 陪伴玩具领域,声网已经有实际落地案例。
珞博智能(Robopoet)推出的 Fuzozo 芙崽是一款 AI 毛绒陪伴产品,主要通过自然语音对话、角色互动和个性化记忆提供陪伴体验。
与 SwitchBot KATA Friends mini 不同,Fuzozo 是已公开采用声网对话式 AI 技术的商业产品。两者属于不同企业的独立产品,本次 SwitchBot 新品没有公开使用声网服务的信息。
1. 毛绒结构对语音采集提出了更高要求
Fuzozo 的麦克风需要在毛绒玩具结构中工作,同时应对环境噪声和用户说话距离变化。
珞博智能采用声网 Convo AI Device Kit,利用实时语音识别、低延迟语音合成、VAD、智能打断和声纹识别等能力改善语音交互。
其中,VAD、音频处理及打断管理帮助系统处理用户什么时候开始说话、什么时候结束,以及用户在 AI 回复过程中再次发言的问题。
这些能力对于毛绒玩具尤为重要。用户通常不会像使用手机语音助手那样,始终保持固定距离或采用标准化的命令表达方式。
2. 实时语音交互与角色记忆分别由不同系统承担
Fuzozo 的陪伴体验还包括情绪和长期记忆相关能力。
珞博智能使用自有 MEM 多情绪模型和 EchoChain 记忆系统,配合声网提供的实时对话式 AI 基础设施,实现角色个性化及历史互动管理。
这里的技术分工需要明确:声网侧提供实时语音交互相关能力,Fuzozo 的角色设定、情绪模型和长期记忆则属于珞博智能自己的产品技术。
这种架构也适用于其他 AI 玩具厂商。开发者可以选择适合自己产品的大语言模型、角色系统和记忆数据库,再将其接入实时语音交互服务。
3. 已公布的商业化数据
Fuzozo 自 2025 年推出后,十个月内累计销量超过 25 万台,活跃用户日均对话时长接近 50 分钟,上市初期曾在京东上线十分钟内获得超过 1,000 个预订单。
对于 AI 玩具开发者,更有参考价值的是其技术分工方式:实时音频交互能力由专业服务提供,产品团队则集中开发角色、记忆、内容和用户体验。
五. 如何利用声网对话式 AI 开发一款智能玩具?
如果开发一款能够自然聊天的 AI 毛绒玩具,可以将系统划分为设备端、实时语音交互服务、模型与业务服务三个部分。
1. 设备端:完成音频采集、播放和硬件反馈
设备端通常包括麦克风、扬声器、主控芯片、网络模块,以及按键、触摸传感器、灯光或其他反馈部件。
开发时需要根据芯片性能、内存、功耗和网络条件,选择合适的音频采集、编码、传输与播放方式。
如果产品主要依赖云端大模型,还应考虑 Wi-Fi 和蜂窝网络之间的切换、断线重连以及设备离线时可以保留哪些基础功能。
2. 实时语音交互:接入声网对话式 AI 引擎
声网对话式 AI 引擎(Conversational AI Engine)面向实时语音交互场景,提供音频连接、语音活动检测、轮次管理、打断控制和模型服务接入等能力。
开发者可以根据实际架构接入 ASR、LLM 和 TTS 服务,使设备能够将用户语音发送到云端处理,并实时播放生成的回复。
对于 AI 玩具,比较重要的能力包括:
- 实时音频连接:在设备与云端语音服务之间传输音频,支持连续对话。
- VAD 与轮次检测:辅助判断用户是否开始或结束发言,减少抢话和无效等待。
- 智能打断:用户在玩具播报时插话,系统可以按配置处理新的输入。
- 流式语音输出:逐步生成和播放 AI 回复,降低长文本语音等待。
- 自定义模型接入:结合角色大模型、知识库和业务服务构建不同的陪伴产品。
在智能硬件开发方面,声网还提供对话式 AI 开发套件及设备接入相关方案,帮助开发者结合硬件条件搭建语音交互产品。
具体支持的芯片、操作系统、网络连接方式和 SDK 能力,应以当前版本的官方开发文档为准。
3. 模型与业务服务:管理角色、记忆和设备动作
AI 玩具的角色性格、长期记忆和动作规则,通常需要产品开发者自行设计。
例如,角色模型可以决定玩具使用怎样的语气回答,Memory 系统保存用户授权的偏好和历史信息,业务后台则负责账户、订阅、设备绑定及其他管理工作。
当玩具需要控制灯光、马达或外部智能家居设备时,可以通过工具调用生成结构化操作请求,再由业务程序完成权限和状态校验。
对于涉及实体设备动作的请求,模型生成了指令并不代表动作已经执行成功。应用应根据设备侧回执更新状态,再决定是否向用户反馈。
同样,触摸反馈、眼部表情和马达控制等能力也需要设备端的硬件驱动与控制逻辑,不能简单理解为接入对话式 AI 引擎后就自动具备。
六. AI 智能玩具量产,还需要考虑哪些问题?
能够通过 Demo 完成语音问答,只是 AI 玩具开发的早期阶段。产品进入日常使用后,还需要解决硬件环境、服务成本和长期运营问题。
1. 网络变化和设备功耗
随身携带的 AI 宠物可能在家庭、户外或不同网络环境中使用。
如果语音服务依赖云端模型,网络质量变化就可能影响音频传输和回复速度。设备还需要平衡待机监听、联网、音频播放和电池续航之间的资源消耗。
因此,开发者需要明确哪些功能可以在端侧完成,哪些必须访问云端,并设计网络不可用时的提示和降级方式。
2. 实际对话成本
AI 玩具的云端成本通常与模型调用、语音识别、语音合成、实时传输和使用时长有关。
与偶尔调用的语音助手相比,陪伴玩具可能在一天内发生多次、较长时间的对话。
例如,假设某款产品有一万名日活跃用户,每人每天平均使用二十分钟,那么每天需要处理约二十万分钟的语音交互。
实际成本应根据并发规模、音频处理架构、模型定价及服务器资源计算,不能只用单次 LLM 请求的费用估算。
SwitchBot KATA Friends mini 为语音对话和设备控制设置付费订阅,也反映出持续 AI 服务需要单独考虑运营模式。但这并不能证明其具体成本构成或盈利水平。
3. 多用户识别与隐私保护
AI 玩具可能被多个家庭成员共同使用。系统需要考虑不同人的语音、偏好和历史记录如何区分,以及是否允许共享某些信息。
如果产品面向儿童,还应特别注意对话内容过滤、个人信息收集、监护人权限和数据删除机制。
对于声音克隆、声纹识别及长期记忆等功能,应有明确的授权和使用范围,避免未经允许保存或使用个人语音特征。
4. 长期体验与版本更新
AI 陪伴产品需要在长期使用中保持角色表现一致,同时允许模型、语音和互动内容持续更新。
如果某次模型升级突然改变角色性格,或者记忆系统更新后丢失此前的重要设定,就可能影响用户体验。
因此,除了实时语音性能,还需要测试角色一致性、记忆准确性、设备状态恢复,以及模型和固件版本之间的兼容性。
七. AI 智能玩具的自然交互,需要软硬件共同配合
SwitchBot KATA Friends mini 将自然语音聊天、个性化性格、触摸反馈和智能家居控制整合到一款便携式 AI 宠物中,展示了 AI 陪伴硬件在交互方式上的进一步扩展。
实现这些功能,需要设备采集和播放音频,也需要模型理解用户意图、管理历史对话,并在适当的时候触发表情、声音或设备动作。
对于采用云端模型的产品,实时音频传输、语音活动检测、轮次判断和智能打断,都会直接影响对话是否流畅。
Fuzozo 芙崽提供了另一个已经商业化的实践案例:珞博智能采用声网对话式 AI 开发套件建设实时语音交互能力,并通过自己的情绪模型与记忆系统形成产品特色。
对于准备开发 AI 智能玩具的团队,可以根据硬件条件和产品定位,利用声网对话式 AI 引擎及相关开发套件搭建实时语音交互服务,再接入自有角色模型、长期记忆和设备控制逻辑。
从原型到量产,还需要持续验证语音识别、打断、网络稳定性、设备功耗、运营成本和隐私保护。这些工程问题最终决定了 AI 玩具能否在日常环境中保持稳定、自然的交互体验。